


"AI 做药" 已经不是新话题。真正稀缺的是可核对的进度表 —— 一家大药企把自己的研发流程改造到什么程度、花了多少钱、省下多少钱、哪些环节已经被湿实验验证过。最近罗氏在研发者日上完整公布了其内部对于 AI 的布局,简历了完善的 Lab-in-the-loop 体系,覆盖了立项,筛选设计,评估,成药性,临床,甚至财务。
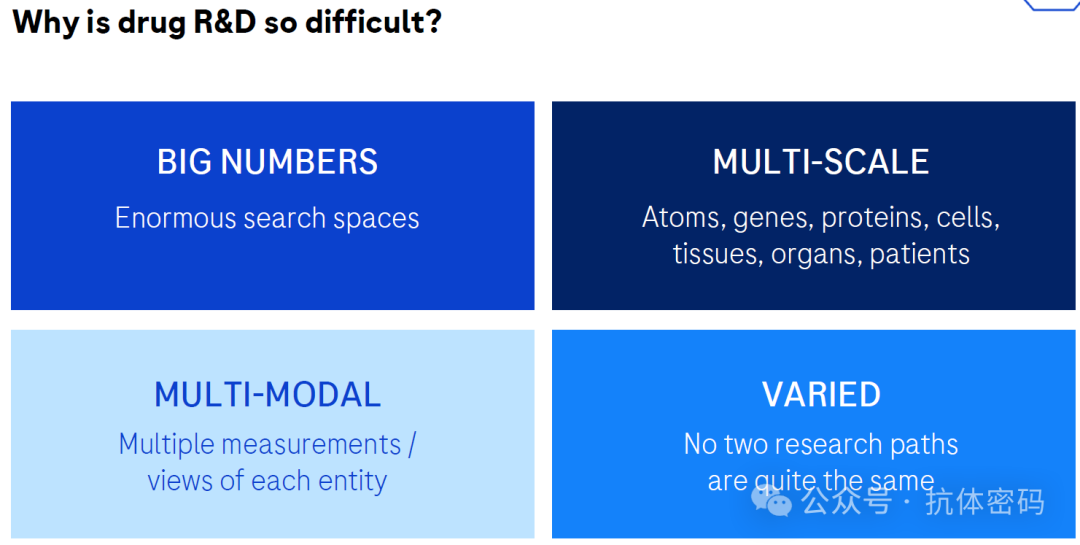
多数 AI 制药叙事的主语是 "模型":训练一个模型,预测一个性质,命中率提高多少。罗氏的框架把主语换成了 "循环"。
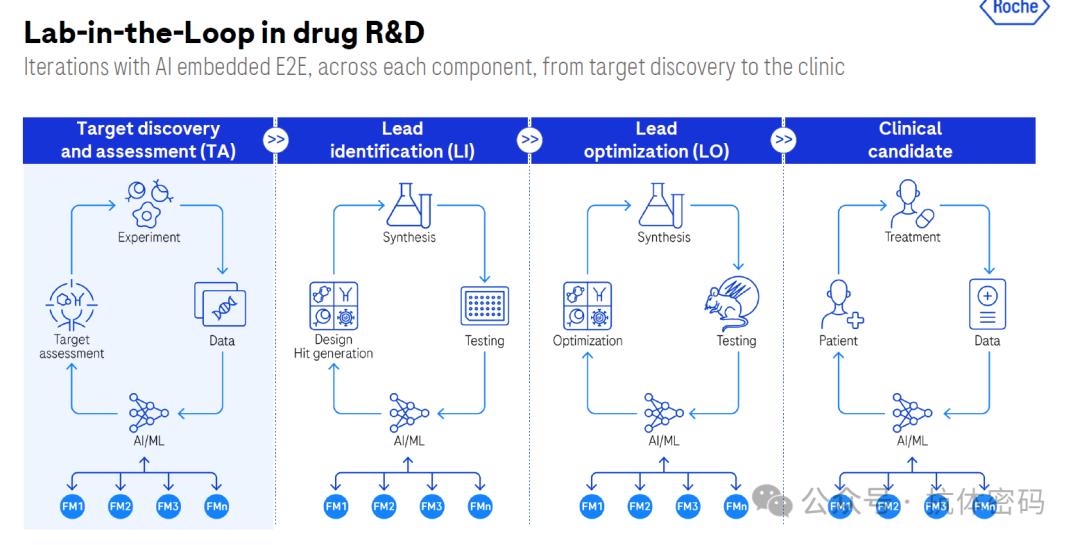
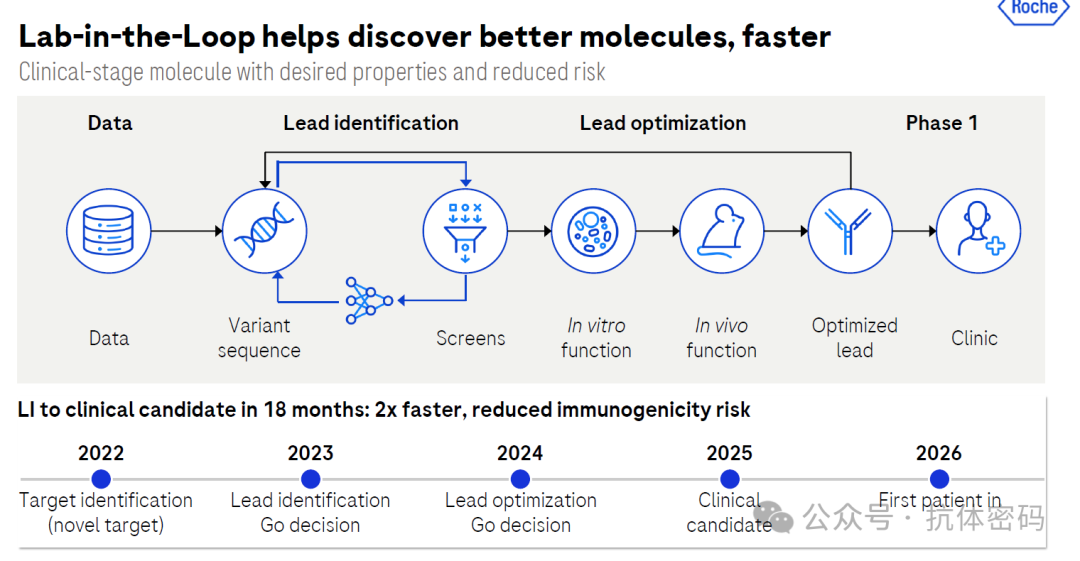
这个概念图只有四个模块:实验室(或临床)产生数据,数据喂给 AI/ML,AI/ML 的输出回到实验里验证。循环里没有终点,只有迭代轮次。这个差别在工程上很实在 —— 一次性预测的性能上限由训练数据的覆盖度决定,而闭环的收益来自每一轮实验都同时改进分子和模型。
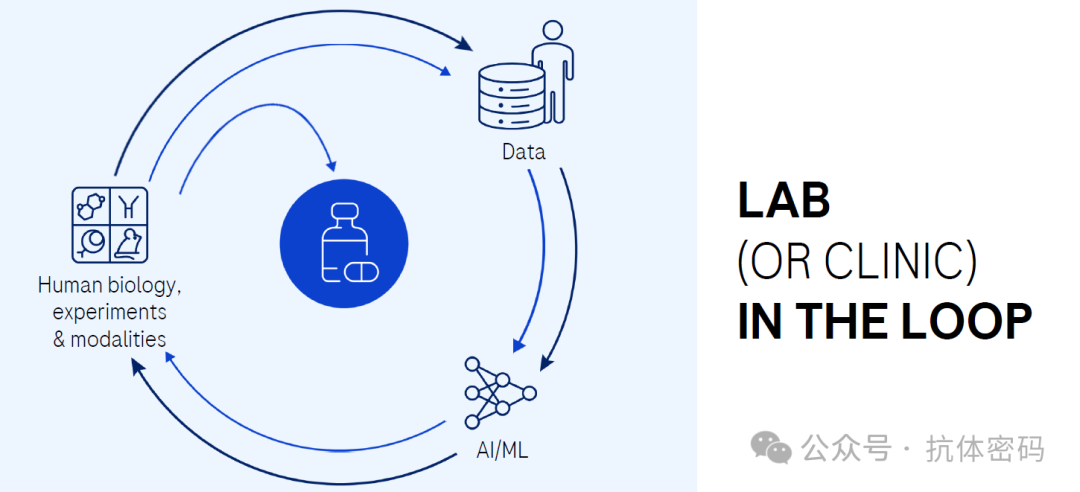
闭环要横跨的不是一个环节,而是从靶点评估(TA)到先导识别(LI)、先导优化(LO)再到临床候选的整条链。
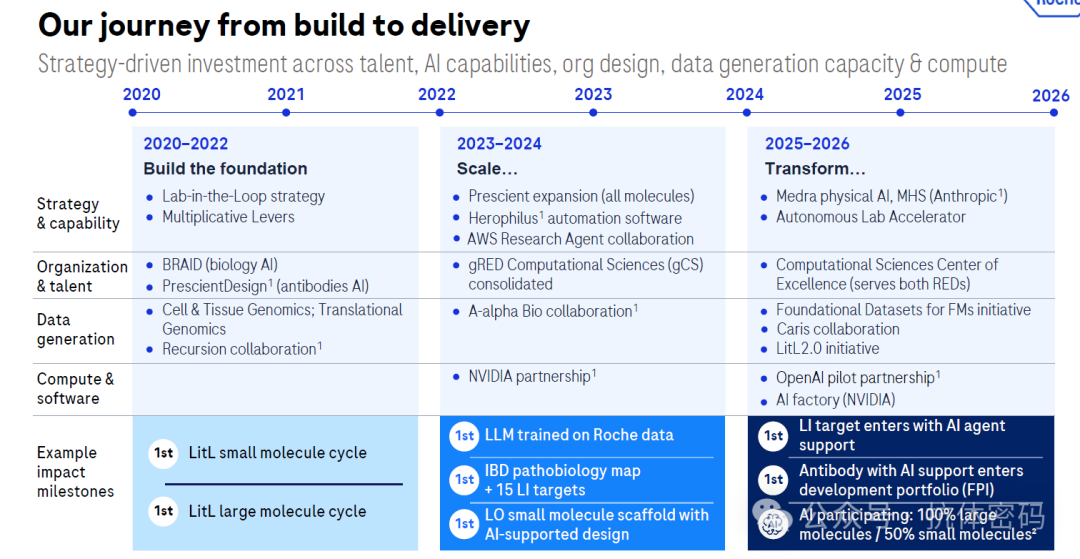
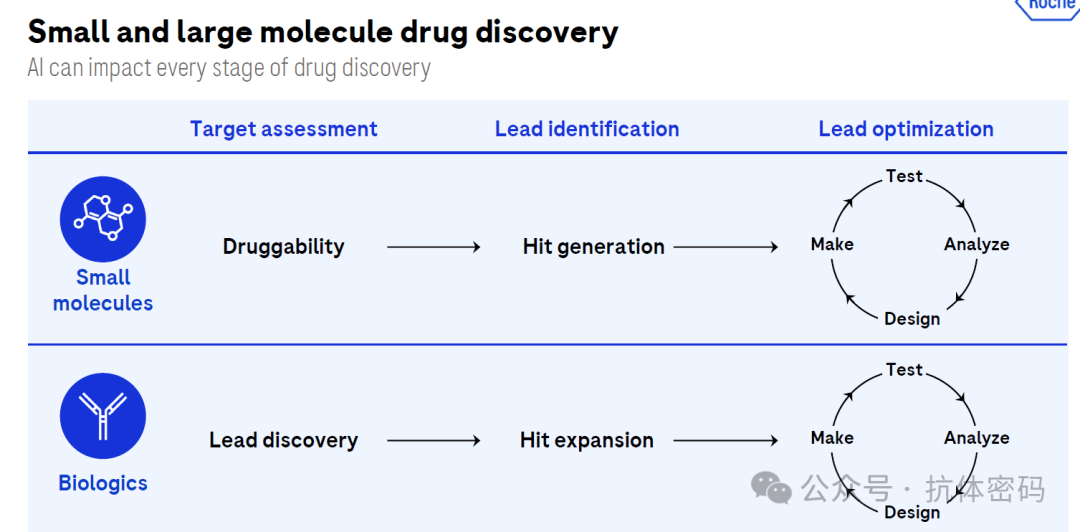
改造不是从零开始自研。罗氏把 2020 年至今切成三段,每个阶段的能力来源、组织形态、算力与数据安排都在变化:
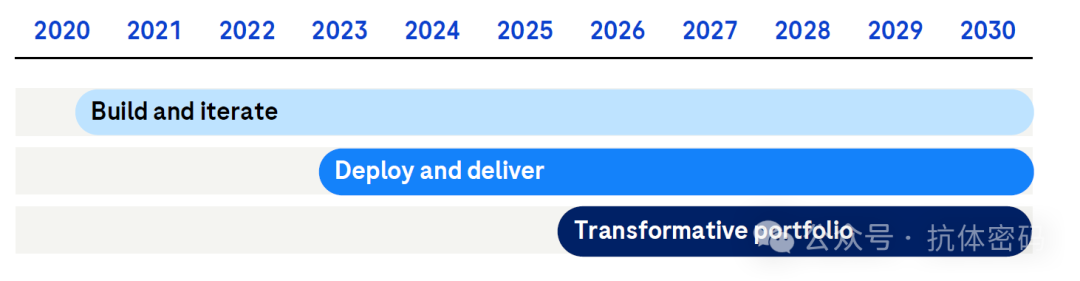
自研与外部合作的比例在往自研一侧移动。2020–2022 年靠合作补齐能力,2025–2026 年出现的是实验室自有的基础模型数据集计划、自主实验室加速器和 "计算科学卓越中心"。配套的里程碑也都是 "第一次"—— 第一个用罗氏数据训练的 LLM、第一个 LitL 小分子闭环、第一个 LitL 大分子闭环、第一个有 AI 参与的抗体进入开发组合(首位患者入组)。
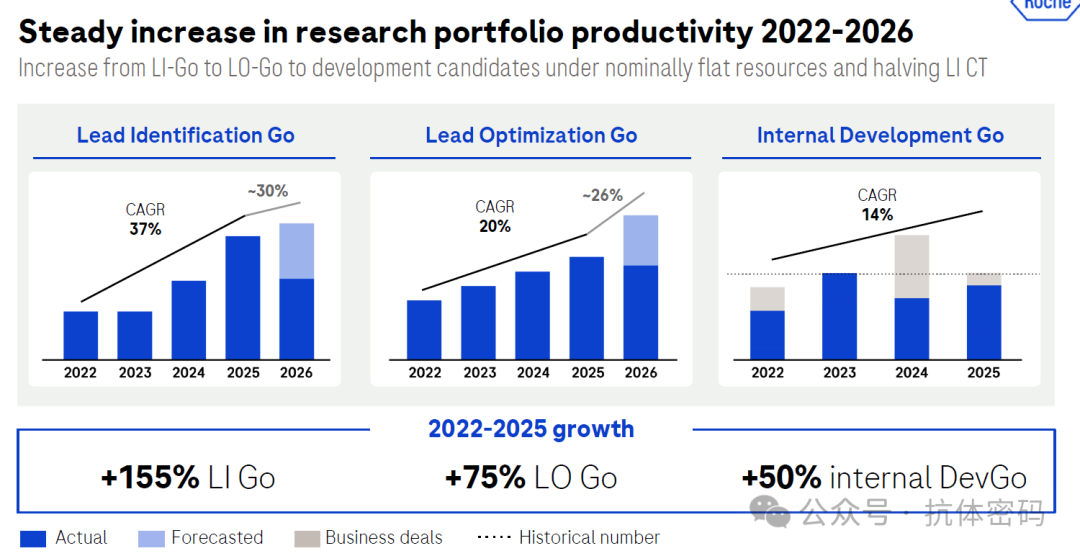
越靠前端增速越快(+155% → +75% → +50%)。这是早期项目储备与后期产出之间的正常时间差 —— 前端放量了,后端需要几年才能体现。同时它也提示一个观察窗口:如果 2028–2030 年内部 DevGo 的增速没有随之抬升,那么前端增长更可能是 "立项变容易了",而不是 "研发变有效了"。
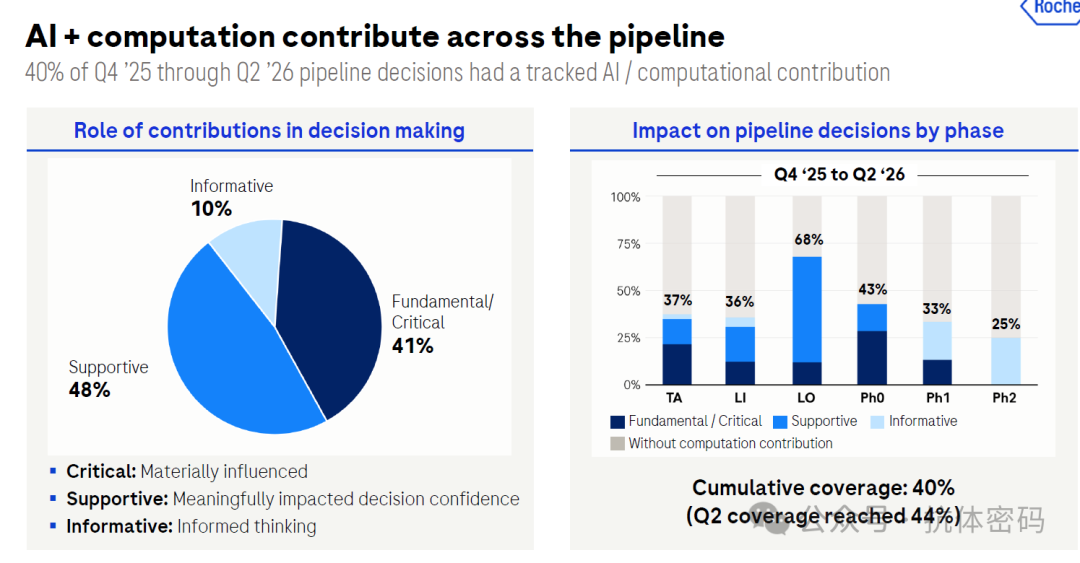
2025 年四季度至 2026 年二季度,40% 的管线决策有可追踪的 AI / 计算贡献(累计覆盖率,2026 年二季度单季达 44%)。按贡献强度分:基础性 / 关键性 41%、支持性 48%、参考性 10%—— 即真正 "实质影响决策" 的部分不到一半。分阶段覆盖率在 25%–68% 之间。
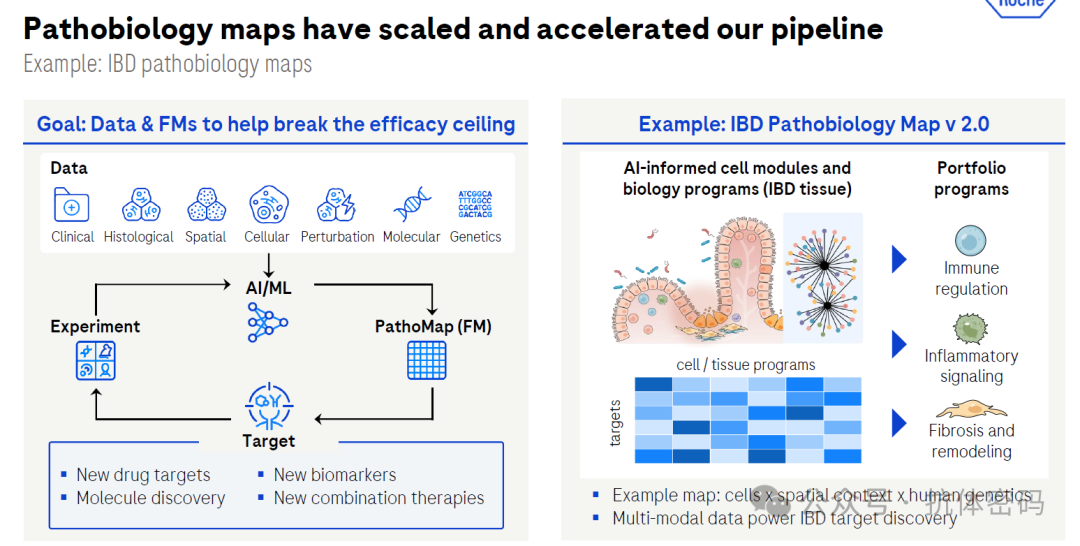
靶点环节的第一件工具是病理生物学地图(Pathobiology Map):把临床、组织学、空间、细胞、扰动、分子、遗传与免疫调控等多模态数据,与实验数据一起送进基础模型,输出带细胞模块注释的地图,再从地图上读出新的药物靶点、生物标志物、分子发现与联合治疗方向。
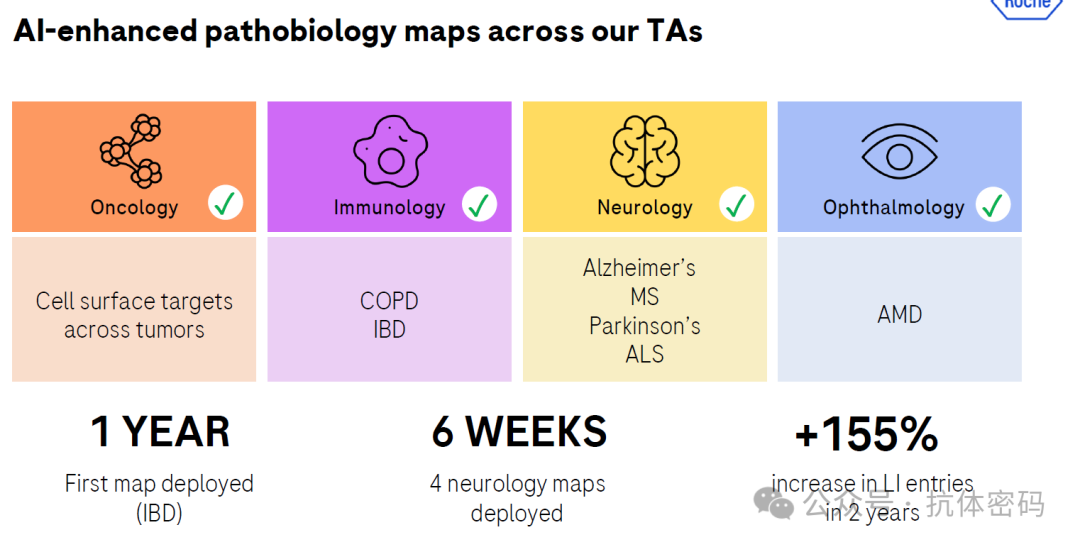
以炎症性肠病(IBD)地图为例,它把炎症信号与纤维化重塑两条通路分解到细胞模块层面。目前这张地图已经铺到四个治疗领域:肿瘤(跨瘤种的细胞表面靶点)、免疫(IBD、COPD)、神经(阿尔茨海默病、多发性硬化、帕金森病、ALS)、眼科(AMD)。幻灯片给出的效率对比是:首张地图(IBD)用了 1 年,此后两年内在神经科学落地 4 张地图、单张周期压缩到 6 周,同期 LI 立项数量增长 155%。地图数量与立项数量的同步上升,是这套方法有效的间接证据
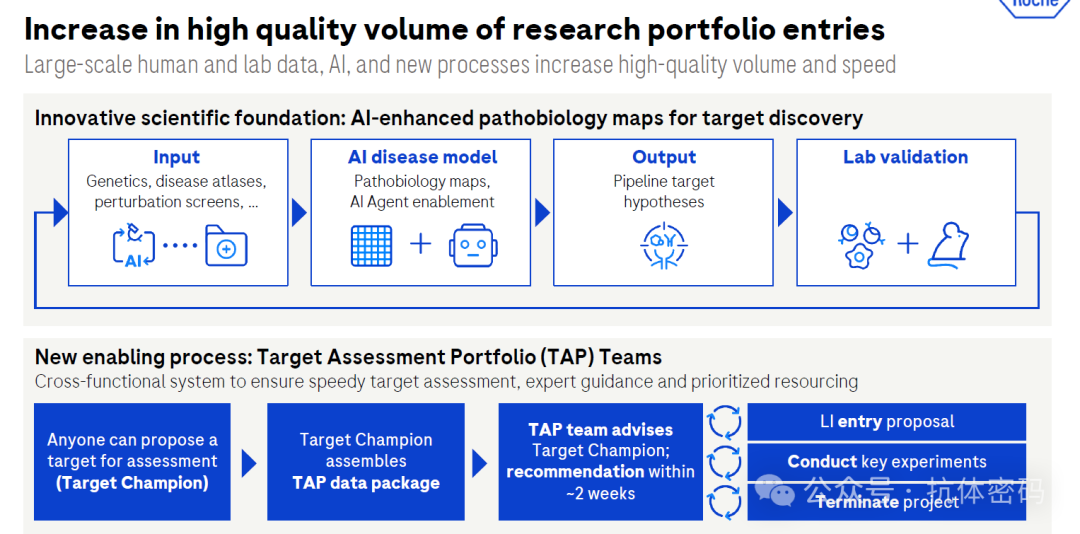
与地图配套的是流程改动:靶点评估组合(TAP)团队机制。任何人(Target Champion)都可以提交靶点进入评估,TAP 团队在一周内给出建议,并承诺在约 2 周内产出一个明确结论 —— 包括终止项目这个选项。把 "终止" 写进流程的承诺里,比提高上线速度更能说明这套机制的目的:它优化的是资源分配的周转率,而不只是立项数量。
让模型学会 "该测什么":主动学习与基础数据集
搜索空间太大是研发的根本约束。罗氏同时从两头压缩:一头是造数据,一头是选数据。
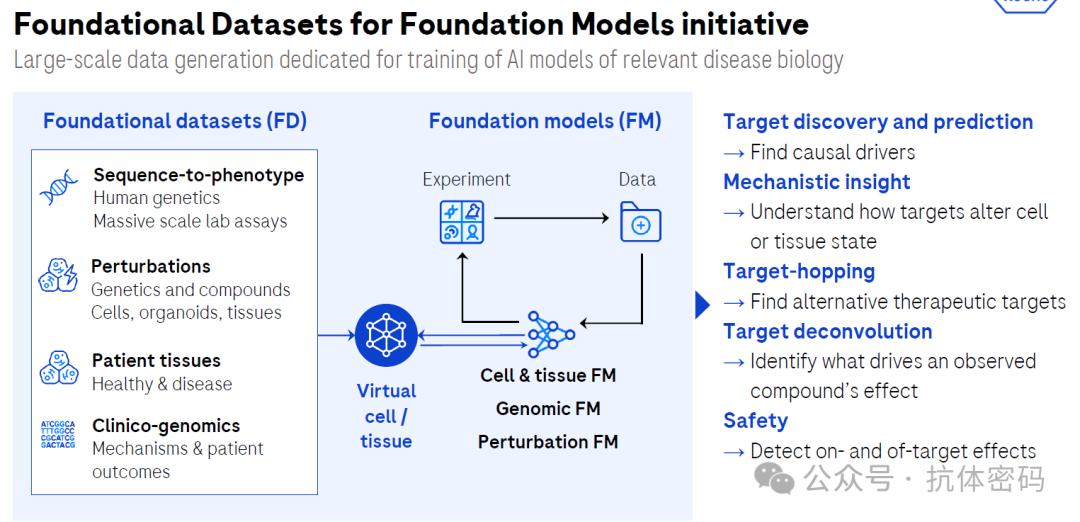
基础模型数据集(Foundational Datasets for FMs)计划的目标是规模化生成专门用于训练疾病生物学模型的实验数据:大规模实验室检测、扰动实验(遗传与化合物)、细胞 / 类器官 / 组织、患者组织(健康与疾病)、临床基因组学,并配套细胞与组织、基因组、扰动三类基础模型,覆盖的用途包括找因果驱动因子、理解靶点如何改变细胞状态、靶点跳跃、靶点解析与安全性判断。
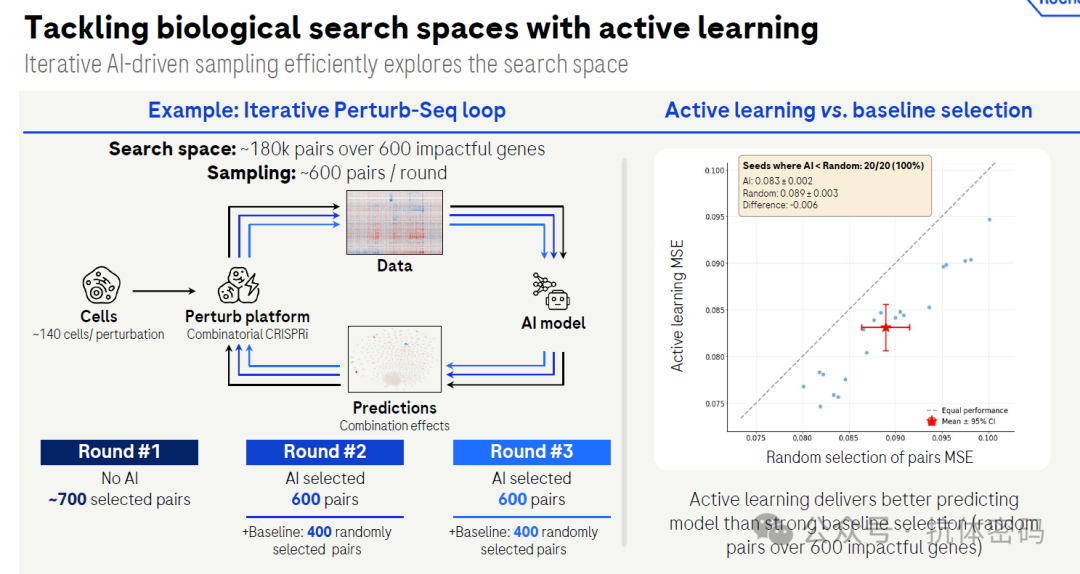
另一头是主动学习。以迭代 Perturb-Seq 为例:搜索空间约 18 万对组合、涉及 600 个关键基因,每轮采样约 600 对,用组合 CRISPRi 平台产生数据(每个扰动约 140 个细胞),模型再决定下一轮测哪 600 对。
结果很干净但幅度不大:在 20 个随机种子中,AI 选样全部优于随机选样(20/20,100%);预测误差 MSE 为 0.083 ± 0.002,随机采样为 0.089 ± 0.003,差异 −0.006。约 7% 的相对改进,统计上是稳的,绝 对幅度是有限的。这符合主动学习的典型收益量级 —— 它节省的是实验通量,不是数量级级别的性能跃迁。
TargetNexus:把靶点评估做成智能体
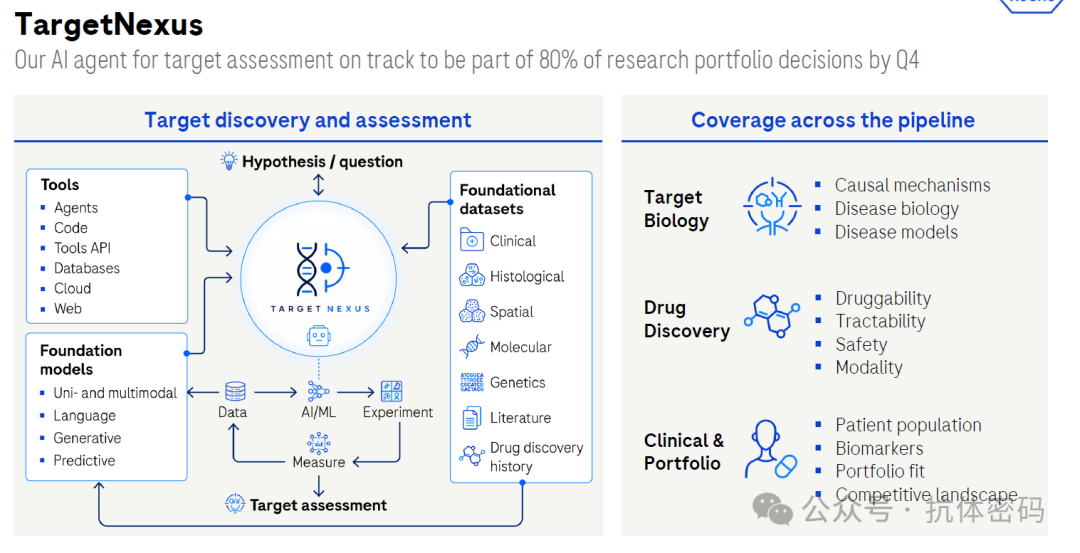
TargetNexus 是罗氏的靶点评估智能体,覆盖三类信息:靶点生物学(因果机制、疾病生物学、疾病模型)、药物发现(可成药性、可及性、安全性、模态选择)、临床与组合(患者人群、生物标志物、组合契合度、竞争格局)。演示稿给的目标是 —— 到 2026 年四季度参与 80% 的研究组合决策。
这个目标值的意义在于它把智能体从 "问答工具" 推向了 "决策流程节点"。配套的流程改动(TAP 团队、2 周结论承诺)说明这不是单纯的效率工具:智能体提供证据包,人做决定,但决定必须在规定时间内作出。
小分子发现:把筛选从 22 万个化合物扩到 900 亿
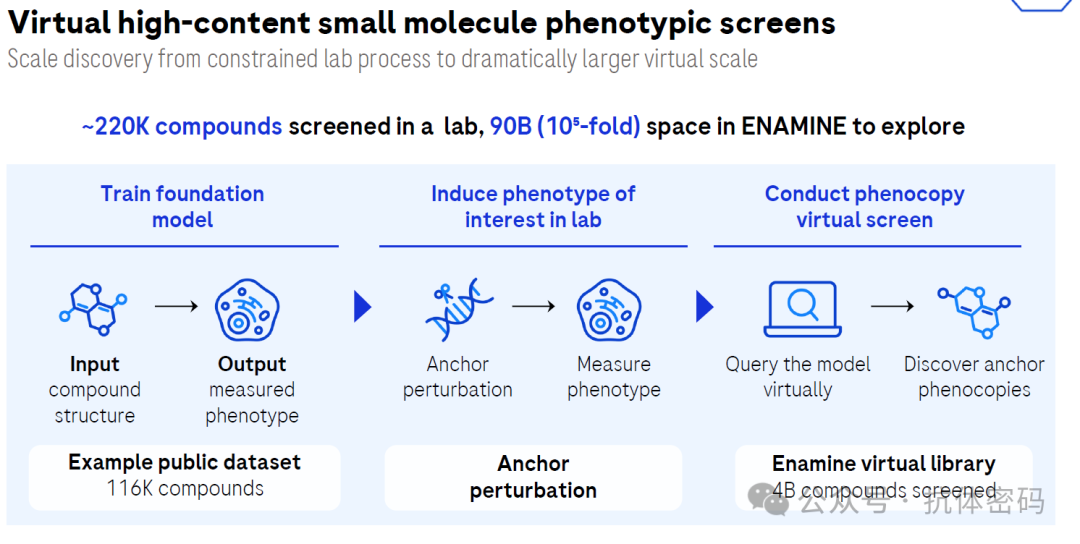
先看规模差距。实验室阶段实际筛过的化合物约 22 万个,而 Enamine 可探索的虚拟空间是 900 亿个(10⁵ 倍差距)。方法上是三步:训练基础模型 → 在实验室诱导出感兴趣的细胞表型 → 用模型做虚拟表型筛选,寻找 "表型模拟物"(phenocopy)。
以公开数据集(11.6 万个化合物)为锚定扰动,在 Enamine 虚拟库中对 40 亿个化合物做了虚拟筛选。规模扩展不等于命中率提升,所以真正要看的是下一步的前瞻性验证。
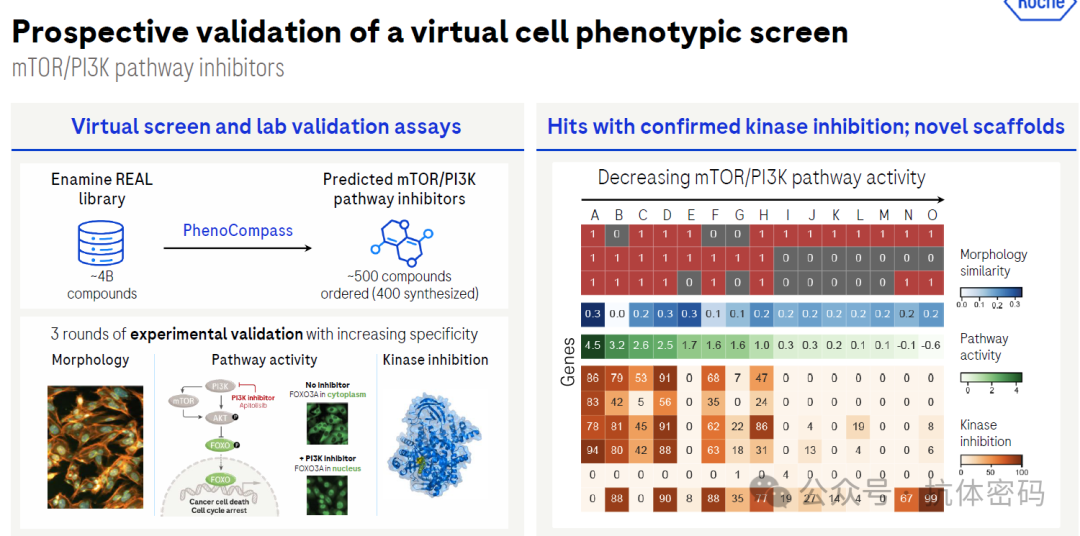
针对 mTOR/PI3K 通路,研究者从 Enamine REAL 库的约 40 亿个化合物中筛出候选,订购约 500 个化合物(其中 400 个完成合成),然后做三轮特异性递增的实验验证:形态学相似度(PhenoCompass)→ 通路活性(读出为 FOXO3A 从胞质转位到核内)→ 激酶抑制。最终拿到的是激酶抑制确证、且骨架新颖的命中物。
这个案例的价值有三层:❶ 它是前瞻性的(先预测、后合成、再验证),而非回顾性打分;❷ 它跨越了两个独立终点(形态学与通路活性),再收敛到机制终点(激酶抑制);❸ 命中的是新骨架。虚拟筛选最容易失败的环节是 "算出好看但做不出、做了但没活性",这里的 400 个合成化合物是实打实的湿实验成本。
抗体与小分子工程:让闭环以周为单位转起来
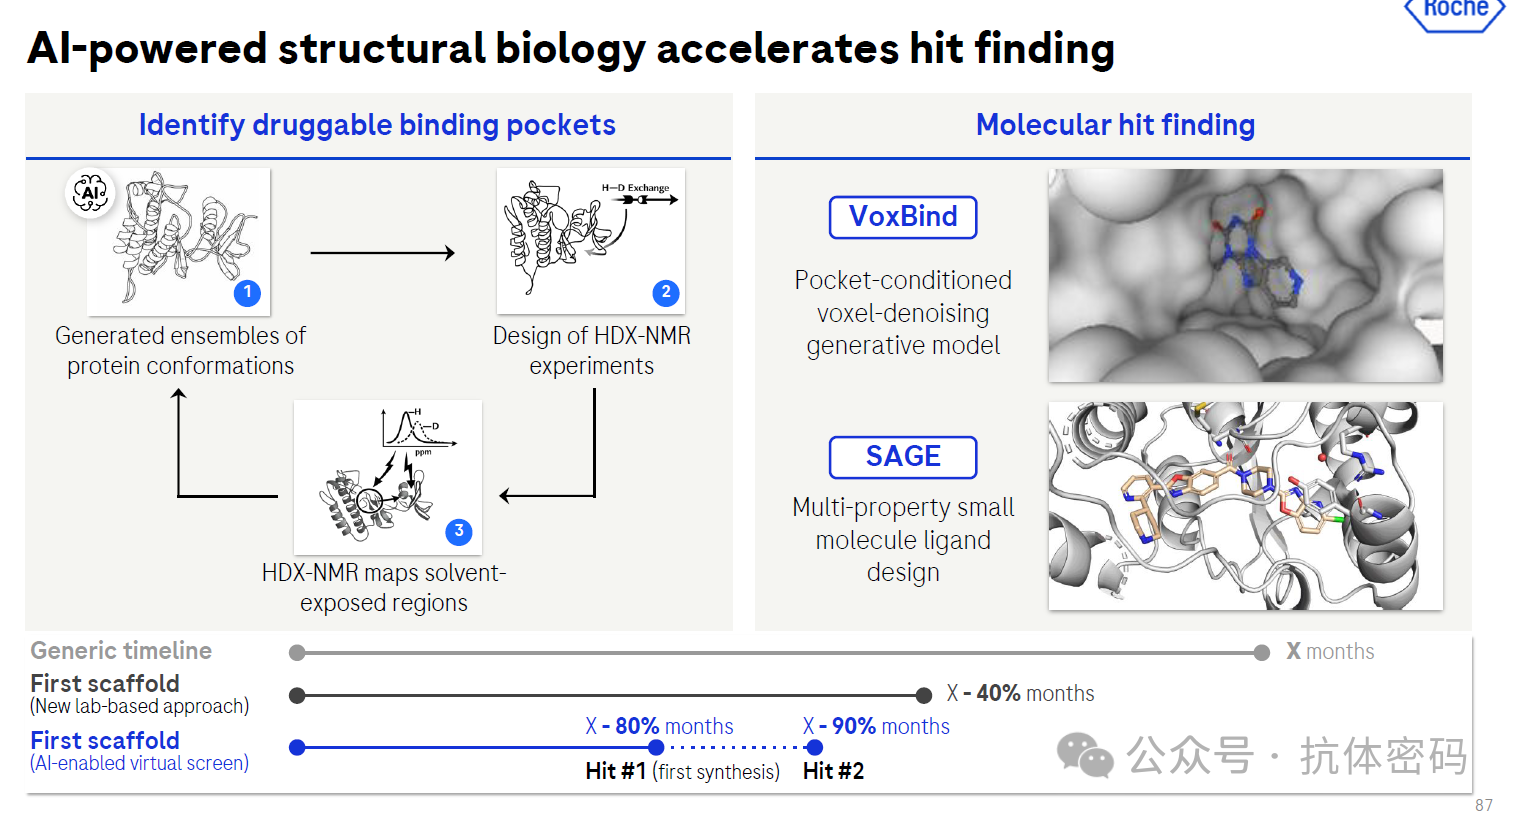
结构生物学加速命中发现。三个工具被串联使用:VoxBind(口袋条件的体素去噪生成模型)生成蛋白构象集合;HDX-NMR 实验测定溶剂暴露区域;SAGE 做多性质小分子配体设计。
通用基线需要 X 个月拿到首 个骨架,新的实验方法路径为 X−40%,而 AI 赋能虚拟筛选路径为 X−80% 至 X−90%。
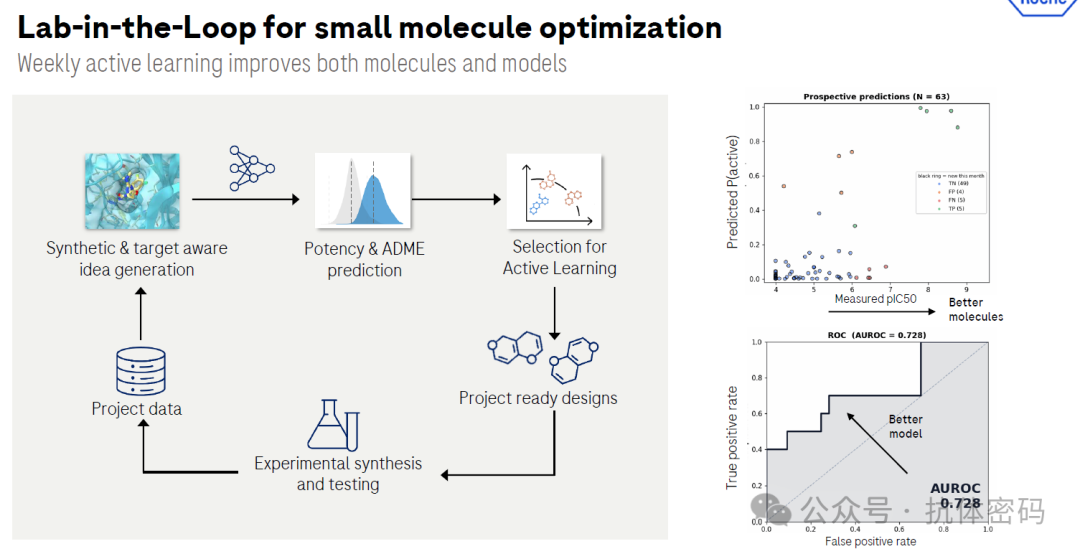
小分子优化的周级闭环。合成与靶点感知的创意生成 → 效价与 ADME 预测 → 主动学习选样 → 合成与测试 → 实测 pIC50 回喂模型。这里有两条同时上升的曲线:分子更好,模型也更好 —— 闭环的核心价值就落在 "模型也更好" 这一侧。
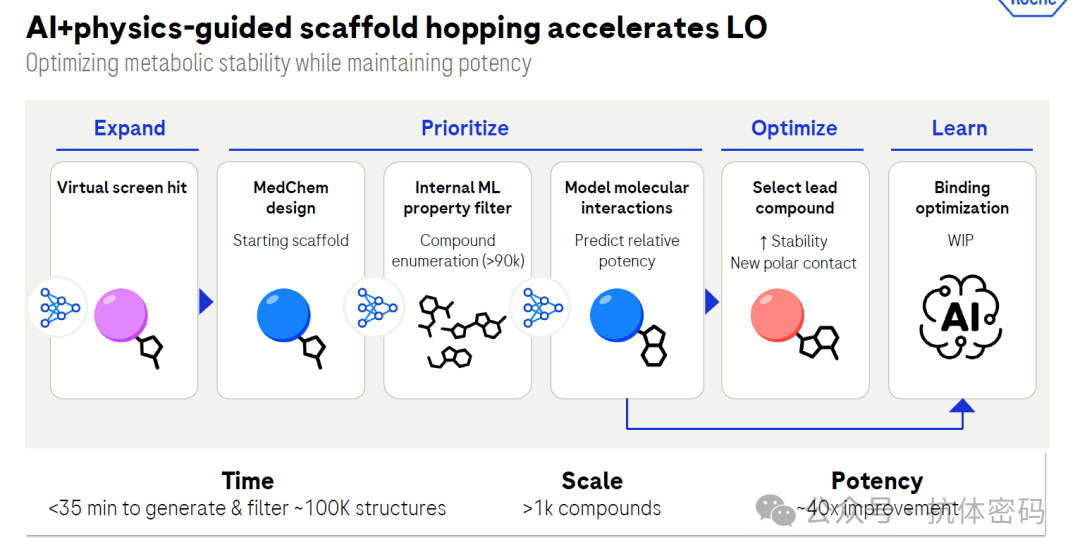
AI + 物理引导的骨架跃迁。目标是在保持效价的同时优化代谢稳定性。流程是把虚拟筛选命中物做骨架枚举(超过 9 万个)→ 药物化学性质过滤与内部 ML 模型排序 → 分子相互作用与结合优化 → 选出先导化合物。两处数字值得记下:生成并过滤约 10 万个结构用时不到 35 分钟;稳定性获得约 40 倍改进,并形成了新的极性接触。
小分子智能体四层堆叠:模型与工具(共折叠、对接、ADME 与效价模型、自由能扰动、枚举)、数据(项目数据、实验结构、DesignHub、小分子砌块)、上下文(项目专有背景、文档与工具、项目历史、药化知识)、以及外层的 LLM + Harness 与推理技能。这个分层说明一件事:智能体的瓶颈不在模型能力,而在上下文与数据的结构化程度 —— 把 "项目历史" 和 "药化知识" 作为独立一层列出来,是在承认这一点。
多特异性抗体:把构建模块做成可复用资产
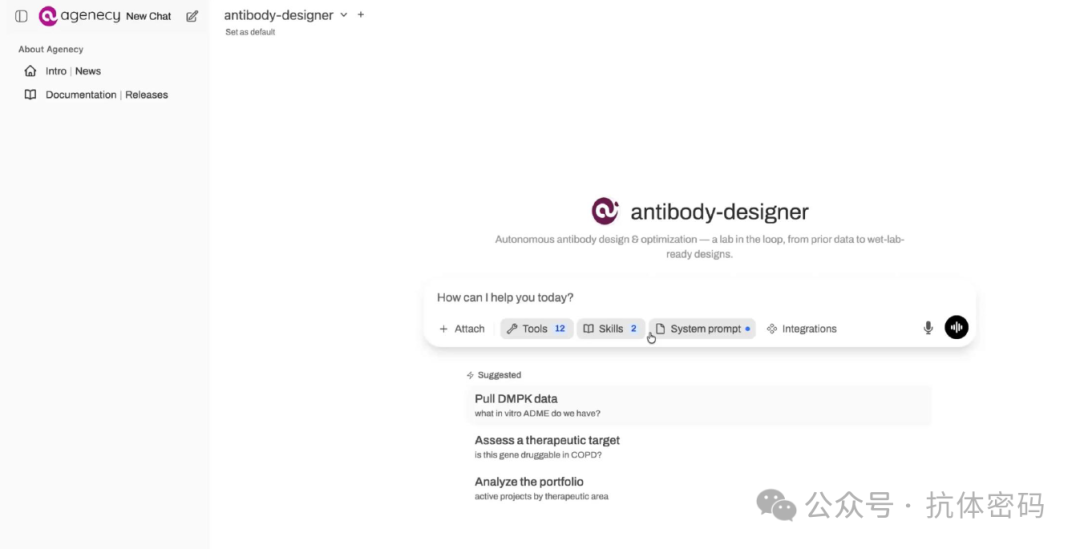
罗氏把多特异性抗体的开发拆成两层:一层是基础构建模块,另一层是多项目执行(示例为 5 个项目并行,其中 2 个由 AI 参与)。逻辑很直接 —— 把每条臂做成经过验证、可互换的模块,就能用模块组合覆盖多个分子,而不是每个分子从头设计一遍。
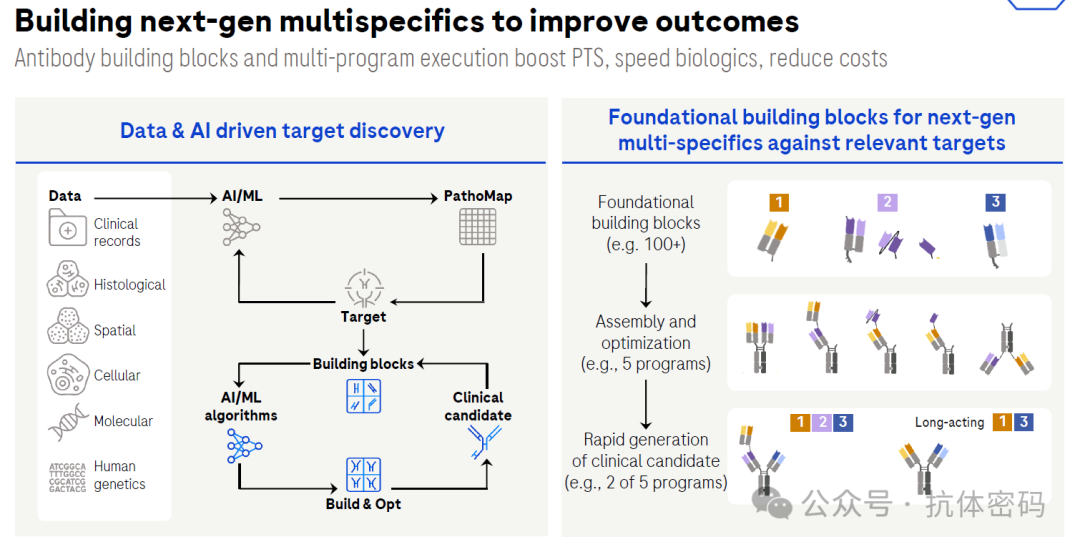
对每个靶点并行制备先导臂与备用臂(来源涵盖大鼠、小鼠、兔、羊驼),要求同时具备高亲和力、交叉反应性与单价条件下的功能活性,再用一个约 1,200 个单突变体的母本亲和力数据集训练两个模型 —— 一个预测药代风险,一个预测可开发性风险,把候选臂放到这两个维度构成的象限里挑选。这是把 "可开发性" 从后期的失败原因,前移成了设计阶段的筛选条件。
自主实验室:把人从操作者变成审计者
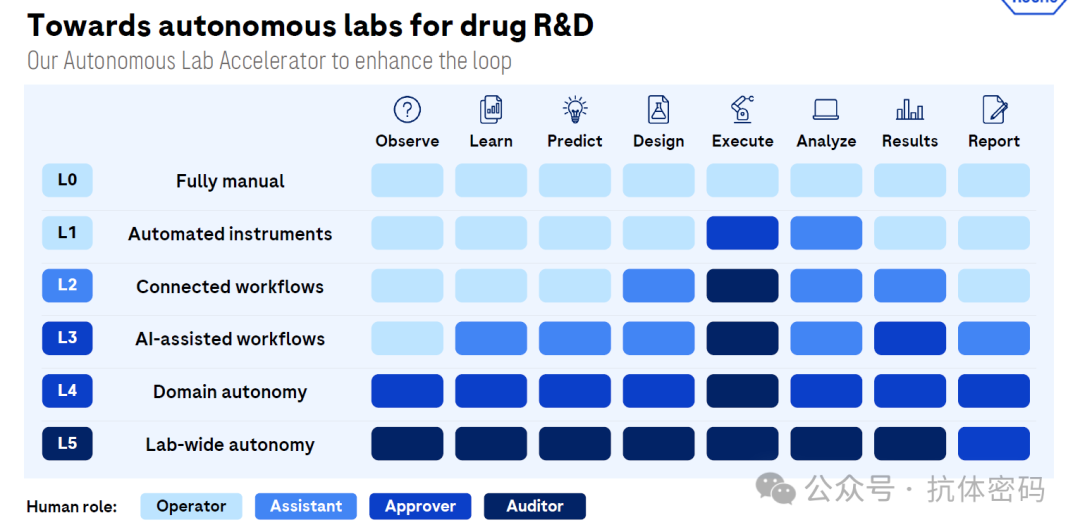
用六层分级定义自主化程度:L0 全手动 → L1 仪器自动化 → L2 工作流联通 → L3 AI 辅助工作流 → L4 领域自主 → L5 全实验室自主。对应的人的角色从操作者 → 助手 → 批准者 → 审计者。
这个分级表的价值不在层级本身,而在它明确了责任转移的路径:随着层级上升,"人" 并不消失,而是从执行转向批准与审计。对药企而言,这决定了验证与合规的框架需要建在哪一层 ——L3 与 L5 的验证要求完全不同。
一个可以核对的案例:18 个月从 LI 到临床候选
最 具体的一个产物:从先导识别(LI)到临床候选只用 18 个月,速度提升 2 倍,同时降低了免疫原性风险。时间线是 2022 年靶点识别(新靶点)→ 2023 年 LI 立项 → 2024 年 LO 立项 → 2025 年临床候选 → 2026 年首位患者入组。
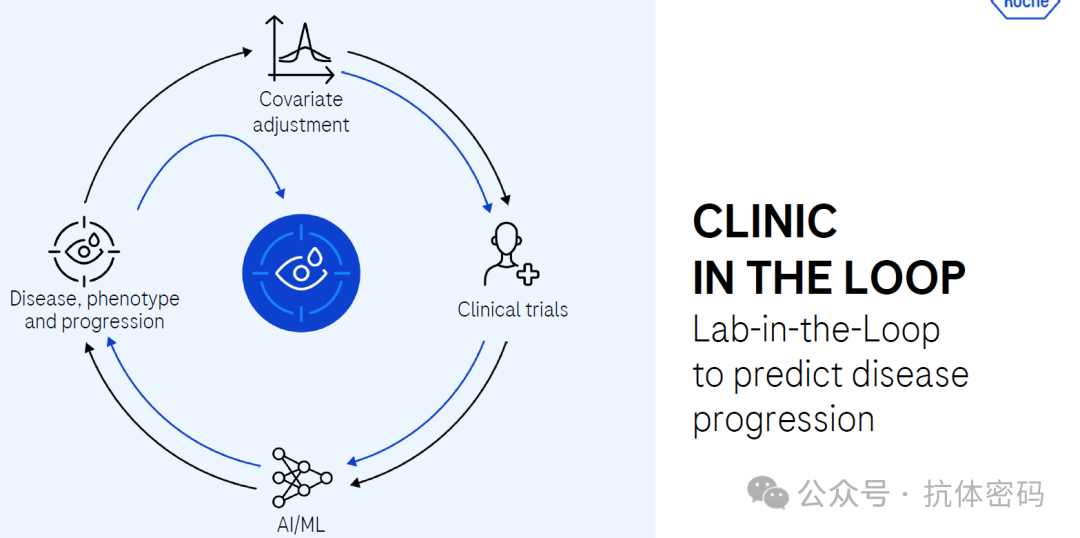
Clinic-in-the-Loop:临床数据回流
闭环的另一端接在临床上。做法是把疾病表型与进展情况、临床试验数据通过 AI/ML 反馈回 Lab-in-the-Loop,用于预测疾病进展
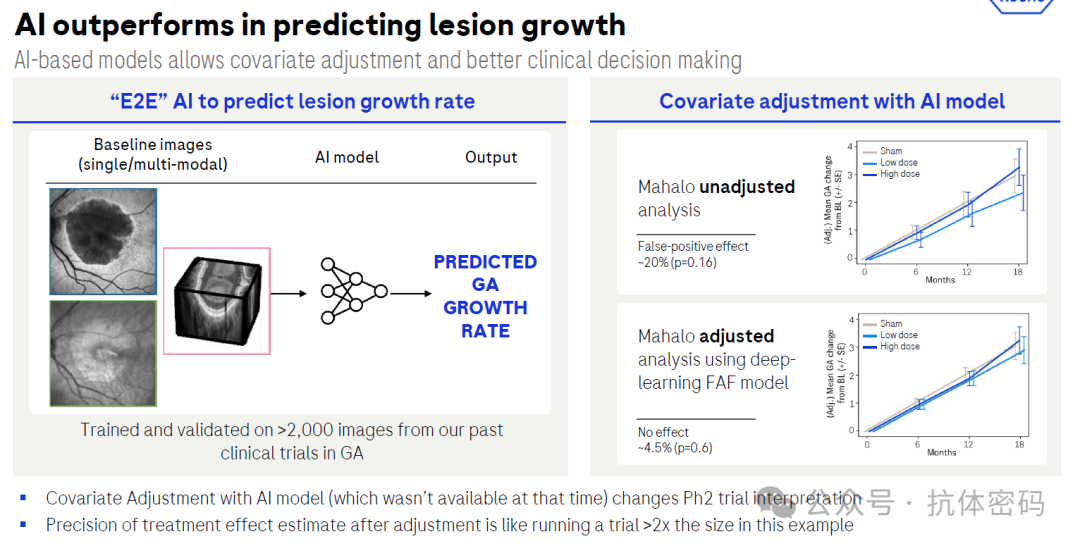
针对地图样萎缩(GA)的 Mahalo 研究,用端到端 AI 模型预测病灶生长率。模型在既往 GA 临床试验的超过 2,000 张图像上完成训练与验证。未做校正的分析显示高剂量组有约 20% 的预测生长率差异(p=0.16),属于假阳性效应;用深度学习 FAF 模型做协变量校正后,差异降为约 4.5%(p=0.6),即无效应。
也就是说,同一个数据集,AI 协变量校正把这个二期研究的解读从 "有信号" 改成了 "无信号"。幻灯片给的正向价值是精度 —— 校正后的疗效估计精度,相当于把试验规模扩大一倍以上。但它还有另一面:如果 AI 协变量校正正在进入常规审评路径,那么它对试验结论的作用力是双向的,既能救活一个被判死的信号,也能否决一个看似成立的信号。这一页是整场演示里最有分量的一页,恰恰因为它展示的是 AI 说 "没有效果"。
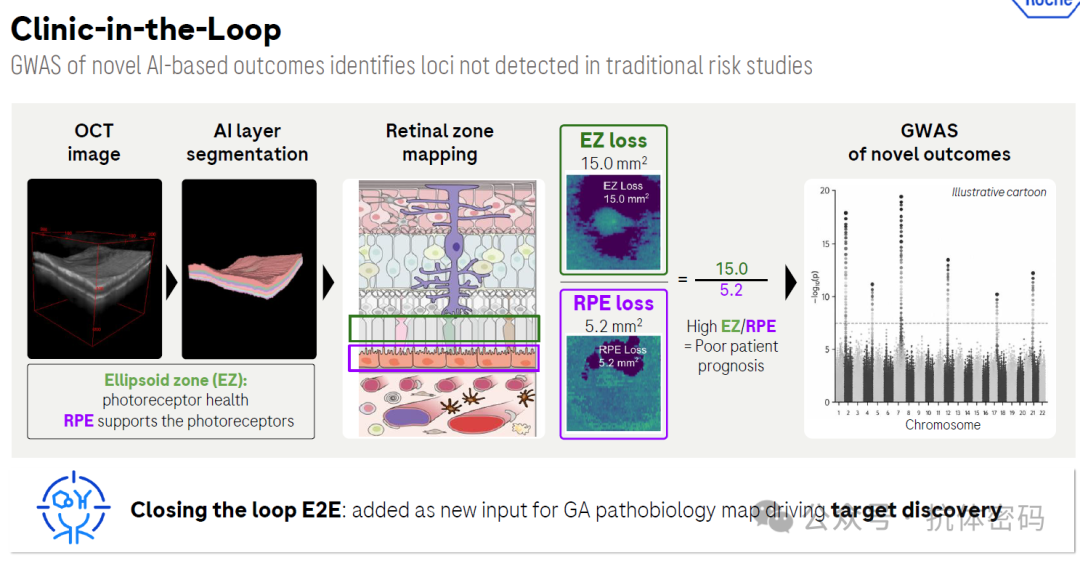
闭环的最后一环是把临床派生的新结局反哺回靶点发现:用 AI 在 OCT 图像上分割视网膜分区(椭圆体带丢失 15.0 mm²、RPE 丢失 5.2 mm²),构造出传统研究里不存在的量化结局,再做 GWAS,发现了传统风险研究中检测不到的基因位点;高 EZ/RPE 丢失对应患者预后差。这些新位点随后作为新输入,回到 GA 病理生物学地图,驱动下一轮靶点发现。到这里,"Lab-in-the-Loop" 与 "Clinic-in-the-Loop" 才真正接成了一个环。
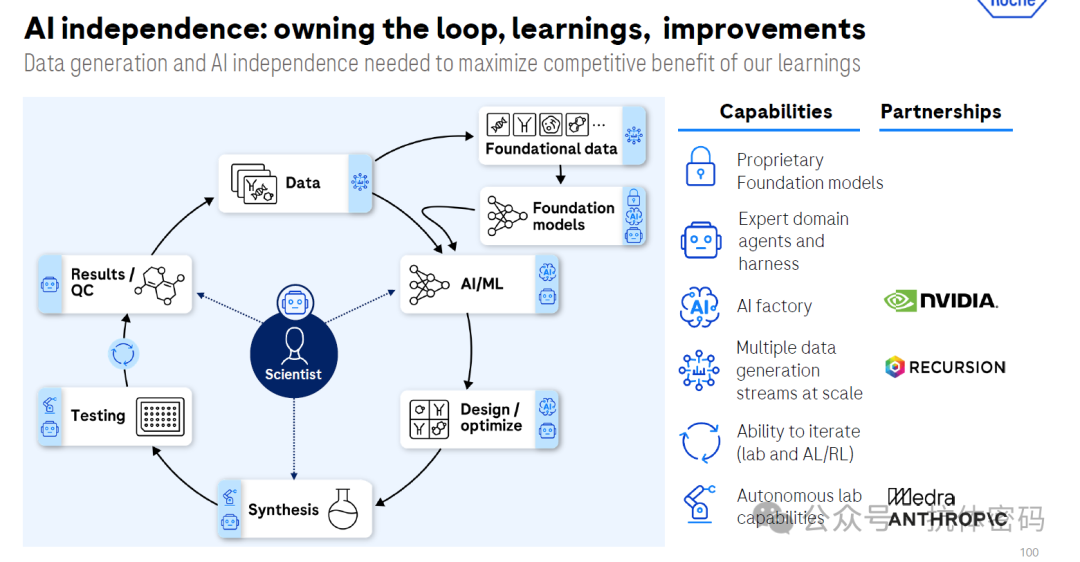
罗氏把自己的能力清单列为专有基础模型、领域智能体与 harness、AI factory、多路规模化数据生成、迭代能力(实验室 + 主动学习 / 强化学习)、自主实验室能力,并明确区分能力(自建)与合作(外部)两类。
这个区分的含义是:模型可以买,数据生成能力与迭代速度不能买。原因在于闭环的收益与迭代轮次成正比 —— 如果迭代速度由合作方决定,那么闭环建立的竞争壁垒就不在自己手里。
闭环优于单点模型。罗氏的框架不是 "用 AI 预测性质",而是实验室数据 → AI → 实验验证的持续迭代。闭环的收益来自每一轮同时改进分子与模型,这套逻辑贯穿了靶点发现、小分子优化、抗体工程与临床分析。
最硬的证据在小分子前瞻性验证上。Enamine REAL 库约 40 亿化合物虚拟筛出候选,订购约 500 个(合成 400 个),三轮特异性递增的湿实验验证后拿到激酶抑制确证的新骨架。规模从实验室的 22 万化合物扩展到 900 亿虚拟空间,这一段的证据链最完整。
Clinic-in-the-Loop 的作用力是双向的。Mahalo 研究中同一个数据集,未校正分析显示约 20% 的差异(p=0.16),AI 协变量校正后降为约 4.5%(p=0.6)——AI 把 "有信号" 改成了 "无信号"。这类方法进入常规审评后,既能救活误判的信号,也能否决看似成立的信号。

 ×
 首页

 我要采购
 我要供应
 我要推广
 我要投稿

