


做抗体药的人都知道,传统抗体发现有多苦:免疫小鼠、筛噬菌体文库、人源化、亲和力成熟、成药性优化——一个抗体从靶点到候选药物,三到五年、烧钱几个亿是常事。
而且核心瓶颈是:你得先有一个已知的 "起点抗体",再在它上面改。如果碰到一个全新的病原体、一个从没被人做过的表位,你连起点都没有,只能从头免疫。去年 12 月 Cell 发了一篇论文,Vanderbilt 大学 Ivelin Georgiev 实验室搞了个叫MAGE(Monoclonal Antibody GEnerator)的模型 —— 你给它一个抗原蛋白的氨基酸序列,它直接输出一对完整的人源抗体重链 + 轻链,不需要模板,不需要结构,甚至训练数据里根本没见过这个抗原也行。
01 MAGE 是怎么炼出来的?
MAGE 的底座是 ProGen2—— 一个在 20 亿条通用蛋白序列上预训练过的大语言模型,20 亿参数,本来是用来生成任意蛋白序列的。
研究者做了件事:把 18,507 对已经发表过的 "抗体 - 抗原配对序列" 喂给它做微调(fine-tuning)。这些数据来自三个公开抗体数据库(CoV-AbDab、SAbDab、PlatDab)加一个叫 LIBRA-seq 的高通量 B 细胞测序数据集,覆盖新冠、HIV、流感、RSV、登革等几十个抗原。
微调完之后,MAGE 就学会了一件事:看到一段抗原序列,预测能结合它的人源抗体的重链和轻链序列是什么。
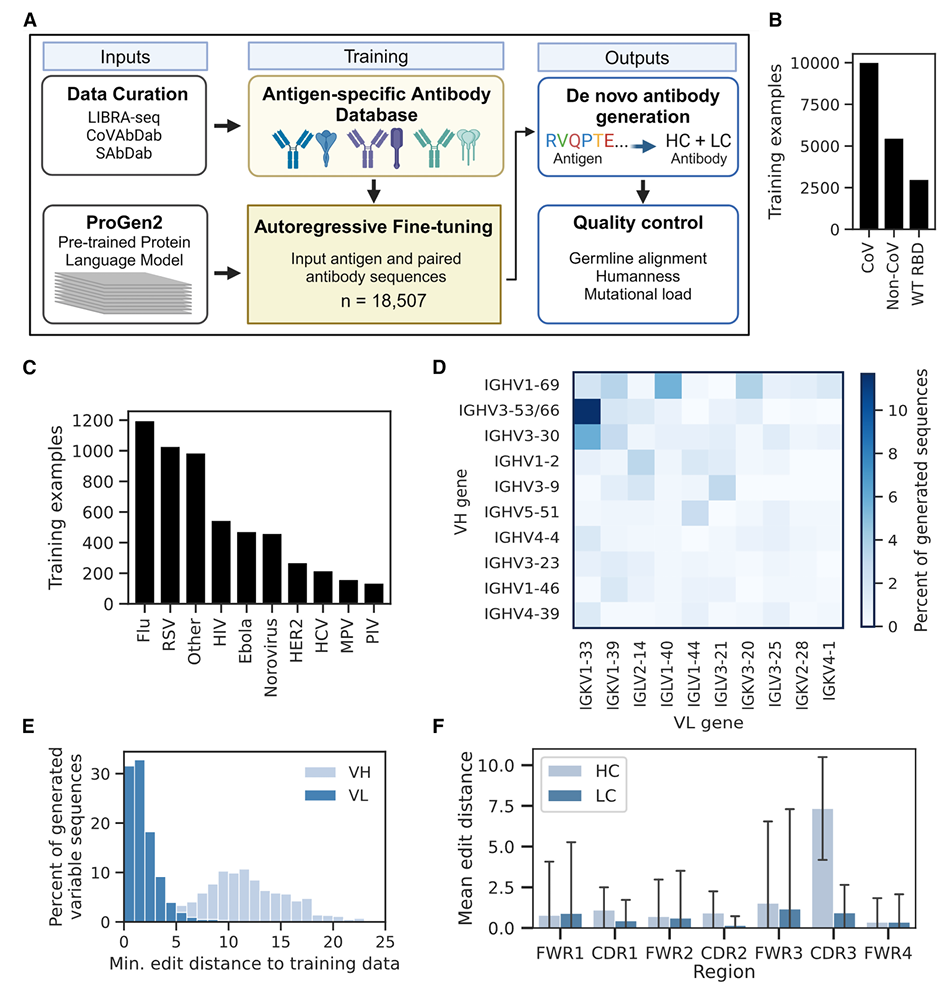
图1:MAGE 工作流程
最关键的一点:它不是 "照着已有抗体抄"。研究者算了生成序列和训练集里最相近抗体的序列距离 —— 重链平均差 11.7 个氨基酸,轻链差 1.4 个。CDR3 区和训练集的一致性平均只有 72.4%,也就是说大量生成的是全新序列,不是记忆复述。
而且它用的胚系基因(V/D/J)组合、CDR 长度分布、体细胞高频突变(SHM)水平,都跟真实人源抗体的分布对得上。不是生成一堆 "看起来像抗体但不是" 的序列。
02 三个靶点,全部实验验证
光生成不算数,得真做蛋白出来测结合。MAGE 选了三个靶点从易到难:
第一个:SARS-CoV-2 RBD(训练数据里最多的)。
给 MAGE 输入 RBD 序列,生成了 1000 条抗体,挑了 20 条做实验。结果:11 条真的能结合 RBD(55% 成功率),其中 4 条能中和新冠假病毒。最好 的 RBD-409 不仅中和原始株,对 Omicron BA.2.75、BA.5、BF.7、XBB 这些变异株都保持中和活性,亲和力到了亚纳摩尔级。
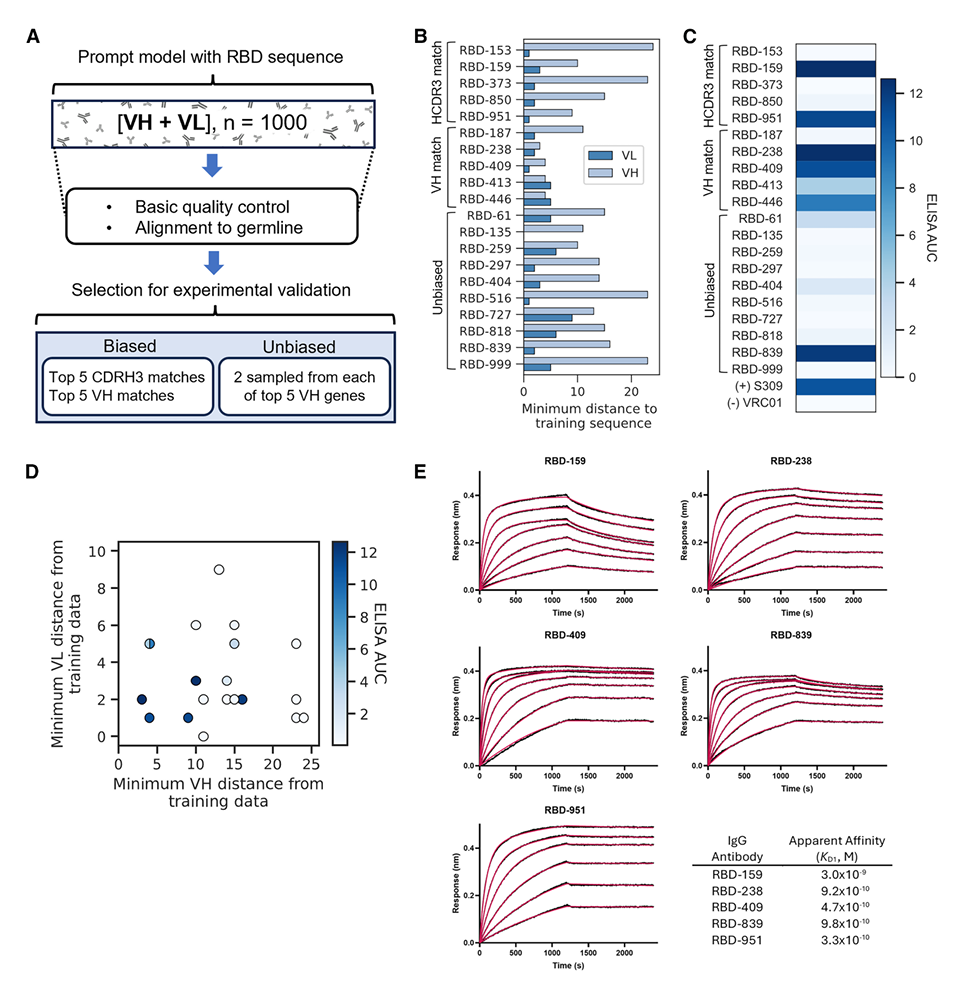
图 2:MAGE 生成的 RBD 抗体 ELISA 和中和数据
第二个:H5N1 禽流感(A/Texas/372024,零样本!)。
这个最炸。训练数据里根本没有 H5N1 的抗体 ——MAGE 是第一次见到这个抗原序列。结果从 18 条候选里筛出 5 条结合血凝素,3 条能中和,IC50 低于 1μg/mL,而且还跨了 H1 和 H5 多个亚型。
换句话说,MAGE 不只是 "背过了新冠抗体长什么样",它真的学到了 "流感中和抗体一般是什么模式" 这种通用知识。
第三个:RSV-A F 蛋白。
生成了 30 条,21 条结合(70%),其中 RSV-2245 和 RSV-3301 两条真的能中和 RSV-A。研究者还做了冷冻电镜,分辨率 3.4Å,发现这两个抗体结合在 RSV F 蛋白上完全不同的两个表位 ——RSV-3301 结合的那个位点,之前文献里都没怎么被报道过。
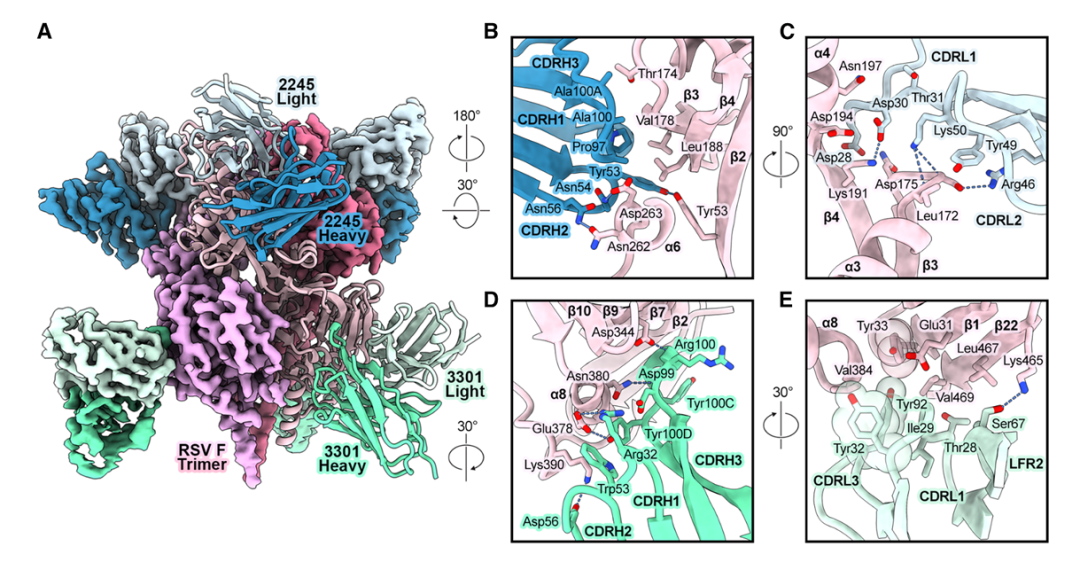
图3:MAGE 抗体与 RSV F 蛋白的冷冻电镜结构
03 为什么这件事值得关注?
以前 AI 做抗体设计,主要有两条路:
一条是结构 - based,用 AlphaFold 之类预测抗体 - 抗原复合物结构,再做点位突变优化。但这条路的问题是 —— 你得先有一个已知抗体作为起点,而且抗体和抗原的对接模拟本身就不准。
另一条是生成模型,但之前的大多只生成单链(重链或轻链),而且要给一个模板抗体作为条件。你不可能凭空让它生成一个全新的配对。
MAGE 的突破在于:它是第一个只给抗原序列、就能从零生成完整配对人源抗体的序列大模型。不需要结构信息,不需要起始模板,重链轻链一起出。
这意味着什么?以后碰到一个全新的突发病原体 —— 比如再来一个类似新冠的病毒暴发 —— 你拿到病毒表面蛋白的序列,MAGE 可能几天内就给你一批候选抗体序列,你直接做蛋白、测结合、挑苗头。整个早期发现阶段从 "月" 压缩到 "周"。
04 先别激动,现实是这样的
这篇论文不是 "AI 抗体已经能直接成药" 了。
几个现实问题摆在这:
第一,成功率还不算高。RBD 靶点 20 条里 11 条结合、4 条中和;H5N1 是 18 条里 5 条结合、3 条中和;RSV 是 30 条里 21 条结合、2 条中和。放在传统筛选里,这个命中率不算差,但离 "生成即用" 还差得远。
第二,生成的是苗头,不是成药。这些抗体还需要做亲和力成熟、可开发性优化、动物实验。论文自己也用 TAP 工具预测了一下,这些抗体的可开发性跟临床阶段抗体差不多,但真正成药还得做。
第三,只在三个靶点上验证过。RBD 和 RSV-F 在训练数据里都有不少相关抗体,H5N1 是零样本但流感血凝素也是研究得很透的靶点。碰到一个真正全新的、没人做过的蛋白靶点,表现怎么样?还不知道。
写在最后
MAGE 这个工作最大的意义,不是它今天生成的抗体马上能拿去上市,而是它证明了一件事:大语言模型在抗体这个领域,真的能从 "序列统计" 走到 "功能生成"。
以前我们觉得 AI 做抗体,最多在已有抗体上做点突变优化。现在看,只要训练数据足够多、模型足够大、微调方法对,它真的能学会 "什么样的抗体序列会结合什么样的抗原" 这件事,并且在没见过的抗原上也能泛化。
这跟大语言模型从 "预测下一个词" 走到 "写代码、做推理" 是一个道理 —— 量变到质变。
做抗体发现的同行们,我觉得现在该认真看一眼这个方向了。

 ×
 首页

 我要采购
 我要供应
 我要推广
 我要投稿

